
Vektör Veritabanı Bellek Hesabı ve Maliyet Matematiği: 1 Milyon Vektör Kaç GB RAM İster?
1 milyon embedding için float32, HNSW, SQ8 ve PQ bellek hesabı; pgvector, Qdrant ve Milvus mimarileri; üretim RAM'i, gecikme ve maliyet planı.
· TankDev Mühendislik
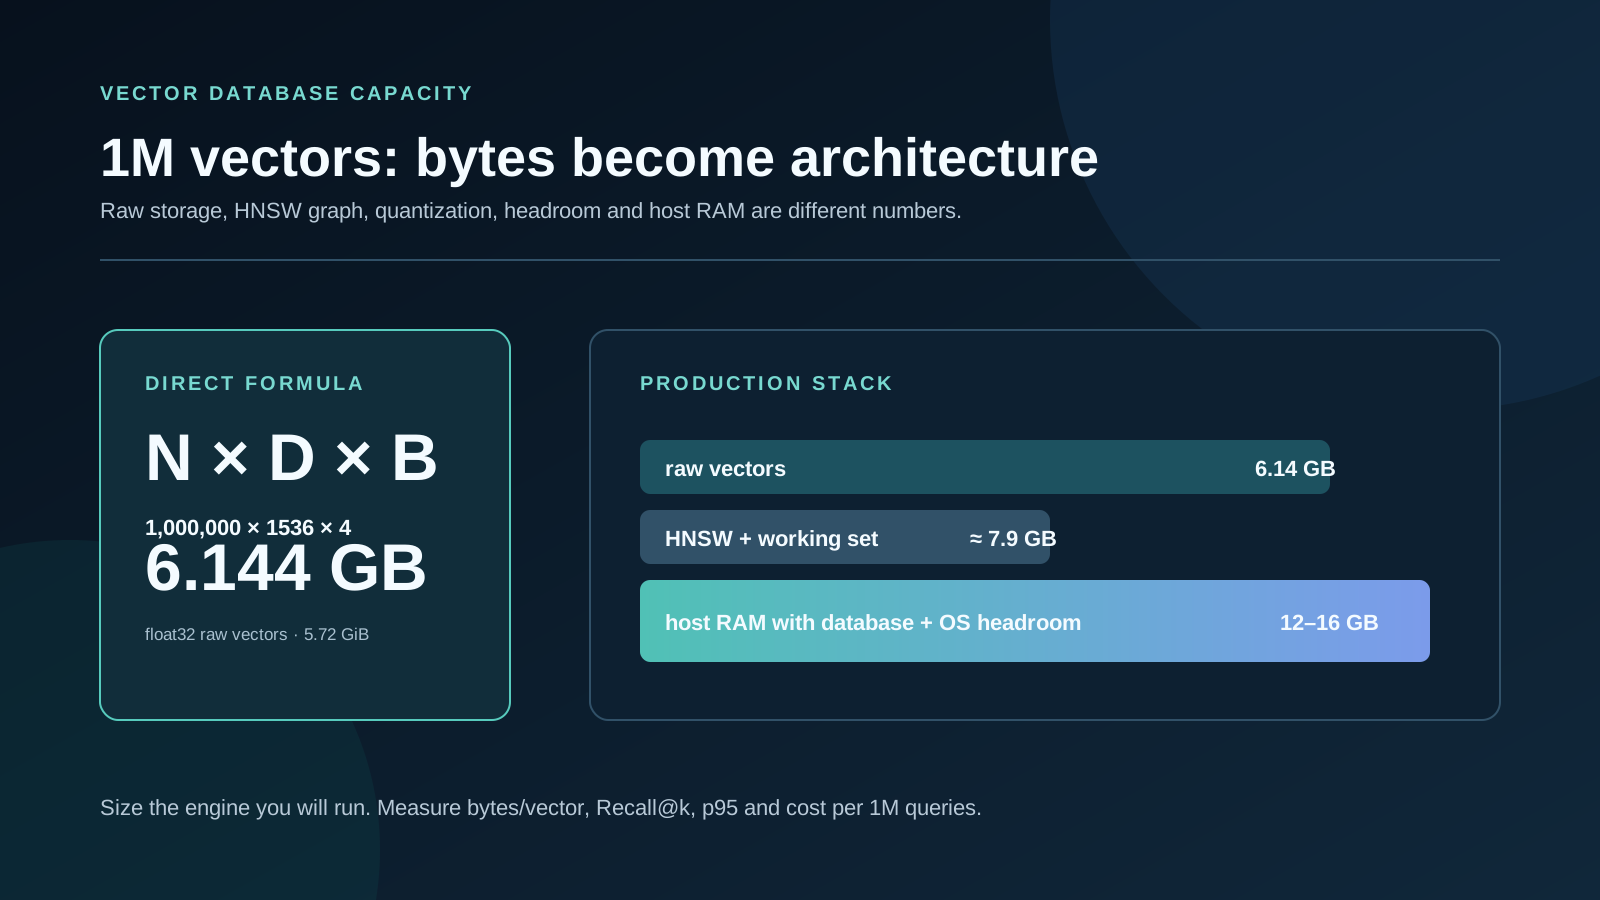
Vektör veritabanı RAM hesabının ilk formülü şudur: Ham vektör boyutu = N × D × B. Float32 için B = 4 byte, float16 için B = 2 byte, int8/SQ8 için B = 1 byte alınır. N vektör adedi, D ise her vektörün boyut sayısıdır. Sonucu decimal GB için 10^9a, binary GiB için 2^30a bölün. Örneğin 1.000.000 adet, 1536 boyutlu float32 vektör 1.000.000 × 1536 × 4 = 6.144.000.000 byte, yani 6,144 GB veya 5,72 GiB ham veri üretir.
1 milyon OpenAI `text-embedding-3-small` vektörü için kısa cevap: Varsayılan 1536 boyut ve float32 saklama kullanıldığında ham vektörler 6,14 GB'tır. M=16 HNSW grafı ve %25 çalışma payıyla salt vektör arama çalışma kümesi yaklaşık 7,9 GB olur; PostgreSQL süreçleri, metadata, filtre indeksleri, sorgu eşzamanlılığı ve işletim sistemi için üretim makinesini en az 12 GB, rahat pay için 16 GB RAM sınıfında planlamak daha güvenlidir. SQ8 kopyası RAM'de, özgün vektörler diskte tutulursa aynı arama katmanı yaklaşık 2,1–2,5 GB çalışma kümesine inebilir; gerçek recall ve p95 gecikme mutlaka ölçülmelidir.
1. Formülü doğru birimlerle kurun: GB ile GiB aynı değildir
raw_bytes = N × D × bytes_per_dimension
decimal_GB = raw_bytes / 1,000,000,000
binary_GiB = raw_bytes / 1,073,741,824

float32: 4 byte/dimension
float16: 2 byte/dimension
int8 / SQ8: 1 byte/dimension
binary: 1 bit/dimension = 0.125 byte/dimension
Bulut sağlayıcıları ve ürün sayfaları çoğu zaman GB, işletim sistemi araçları ise GiB gösterir. 6,144 GB ile 5,72 GiB aynı byte miktarıdır. Bu ayrım yazılmazsa kapasite tablosu yaklaşık %7 yanlış okunur. Ayrıca embedding API'sinin JSON yanıt boyutu depolama boyutu değildir; JSON'daki sayı karakterleri ve ağ protokolü yalnız aktarım maliyetidir. Veritabanı içindeki fiziksel veri tipi esas alınır.
OpenAI'nin resmî embedding rehberi, text-embedding-3-small için varsayılan 1536, text-embedding-3-large için 3072 boyut verir ve dimensions parametresiyle daha kısa çıktı istenebileceğini belirtir. Bu yüzden model adı tek başına kapasiteyi kanıtlamaz; uygulamada gerçekten istenen ve saklanan D değerini ölçün.
2. HNSW indeksini ham vektörlerden ayrı hesaplayın
HNSW, her noktayı çok katmanlı yakın komşu bağlantılarıyla bağlar. Graf belleği boyuttan çok vektör sayısı, bağlantı parametresi M, kimlik genişliği ve motorun veri yapısıyla büyür. HNSW makalesi indeks verisi hariç tipik graf maliyetini uygulamaya göre nesne başına yaklaşık 60–450 byte aralığında tartışır. Bu nedenle HNSW = ham vektörün daima %20–50'si şeklinde evrensel bir kural yoktur; düşük boyutlu vektörlerde oran büyük, 3072 boyutta daha küçük görünür.
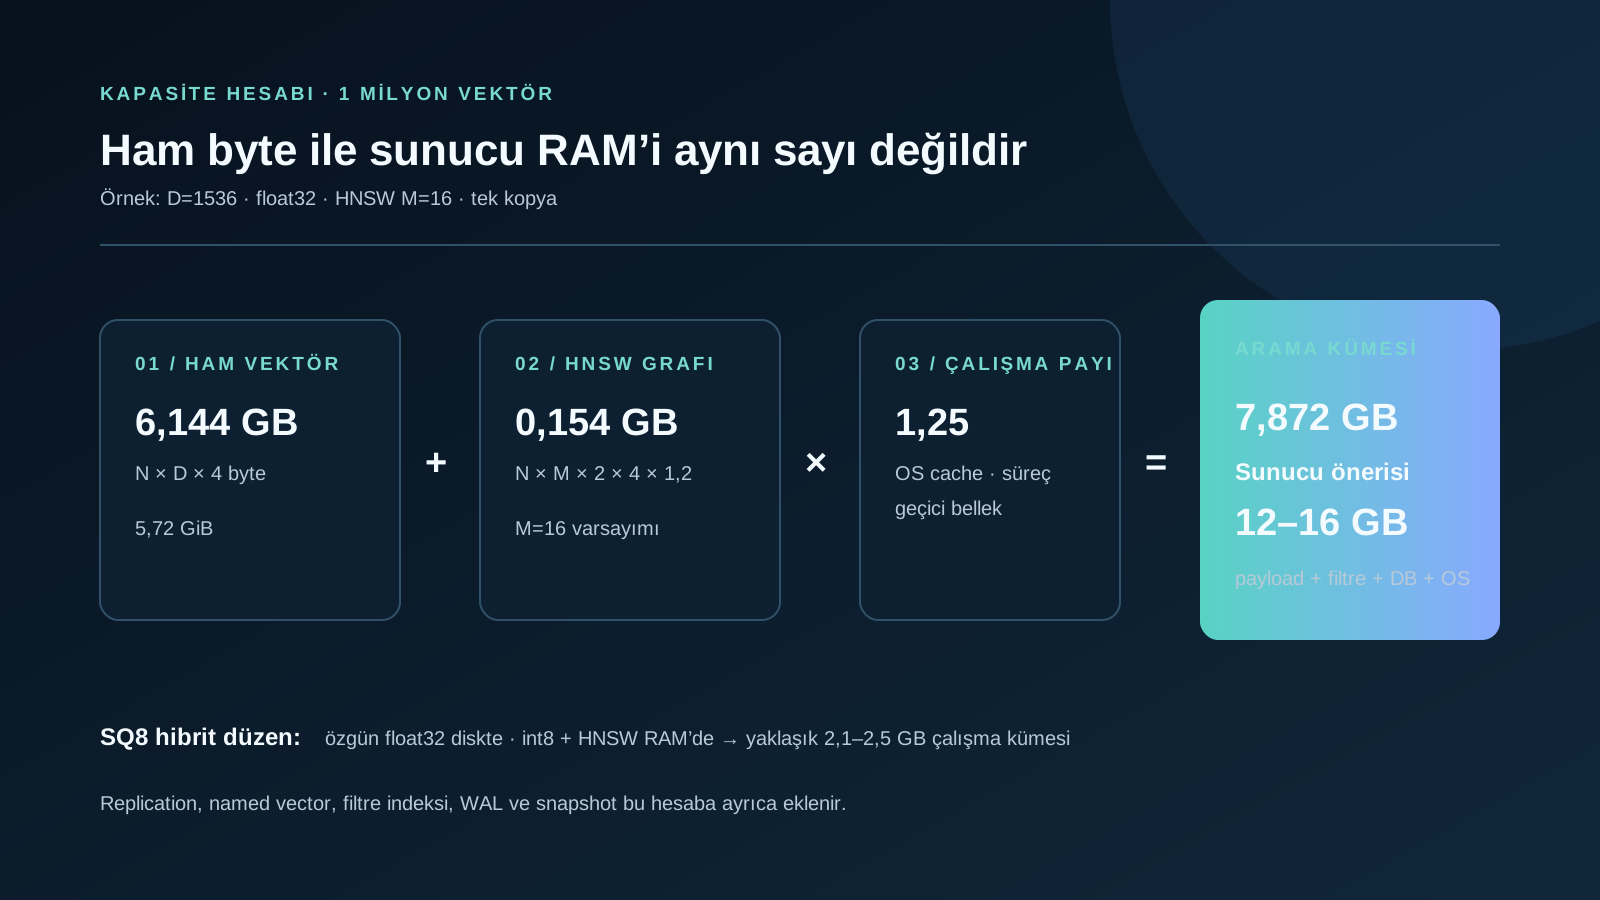
Planlama için motoru belli bir formül seçmek gerekir. Qdrant'ın kapasite planlama rehberi HNSW grafını yaklaşık N × M × 2 × 4 byte × 1,2 olarak hesaplar. Buradaki iki katsayısı çift yönlü bağlantıları, 4 byte nokta kimliğini, 1,2 ise katman ve yönetim payını temsil eder. N=1.000.000 ve M=16 için graf yaklaşık 153,6 MB; M=32 için 307,2 MB olur. Başka motorların işaretçi, hizalama, segment ve kopya düzeni farklı olabilir.
hnsw_graph_bytes ≈ N × M × 2 × 4 × 1.2

N = 1,000,000, M = 16 → 153,600,000 byte = 0.154 GB
N = 1,000,000, M = 32 → 307,200,000 byte = 0.307 GB

resident_search_set ≈ (vector_bytes + graph_bytes + resident_payload_indexes) × headroom3. Bir milyon vektör için karşılaştırma tablosu
| Embedding örneği | D | Ham float32 | HNSW M=16 + %25 pay | SQ8 + HNSW + %25 pay | Pratik sunucu sınıfı |
|---|---|---|---|---|---|
| All-MiniLM-L6-v2 | 384 | 1,54 GB / 1,43 GiB | ~2,1 GB | ~0,7 GB | 4–8 GB RAM |
| BGE-base sınıfı | 768 | 3,07 GB / 2,86 GiB | ~4,0 GB | ~1,2 GB | 8 GB RAM |
| OpenAI text-embedding-3-small (varsayılan) | 1536 | 6,14 GB / 5,72 GiB | ~7,9 GB | ~2,1 GB | 12–16 GB RAM |
| OpenAI text-embedding-3-large (varsayılan) | 3072 | 12,29 GB / 11,44 GiB | ~15,6 GB | ~4,0 GB | 24–32 GB RAM |
Bu tablo bir satın alma garantisi değil, tekrarlanabilir bir başlangıç hesabıdır. M=32, yoğun payload indeksleri, çoklu named vector, tombstone/segment birikimi veya veritabanının vektörü tablo ve indeks içinde ayrı fiziksel biçimlerde tutması sonucu büyütür. Buna karşılık boyutu 1536'dan 768'e düşürmek ham vektör maliyetini doğrudan yarıya indirir; ancak arama kalitesi yalnız boyuttan değil veri ve sorgu dağılımından etkilenir.
4. 1536 boyutlu bir RAG koleksiyonunun adım adım hesabı
N = 1,000,000
D = 1,536
M = 16

raw_float32 = N × D × 4                 = 6.144 GB
hnsw_graph = N × M × 2 × 4 × 1.2       = 0.154 GB
search_working_set = (6.144 + 0.154) × 1.25 = 7.872 GB

SQ8, originals on disk:
quantized = N × D × 1                   = 1.536 GB
SQ8_working_set = (1.536 + 0.154) × 1.25 = 2.112 GB
Üretim makinesi hesabı burada bitmez. Örneğin 1 milyon kaydın her birinde ortalama 1 KB payload varsa 1 GB daha ham payload vardır; bunun tamamı RAM'de olmak zorunda değildir ama sık kullanılan filtre indeksleri resident olabilir. PostgreSQL bağlantıları work_mem tüketebilir, Qdrant optimizasyon sırasında yeni segment oluşturabilir, Milvus sorgu düğümleri yükleme ve compaction için geçici alan ister. Sonuçta 7,9 GB çalışma kümesini 8 GB fiziksel RAM'e yerleştirmek kapasite planı değil, sürekli bellek baskısı tasarımıdır.
5. Kuantizasyon: %75 küçülme doğru, kalite kaybı sabit değildir
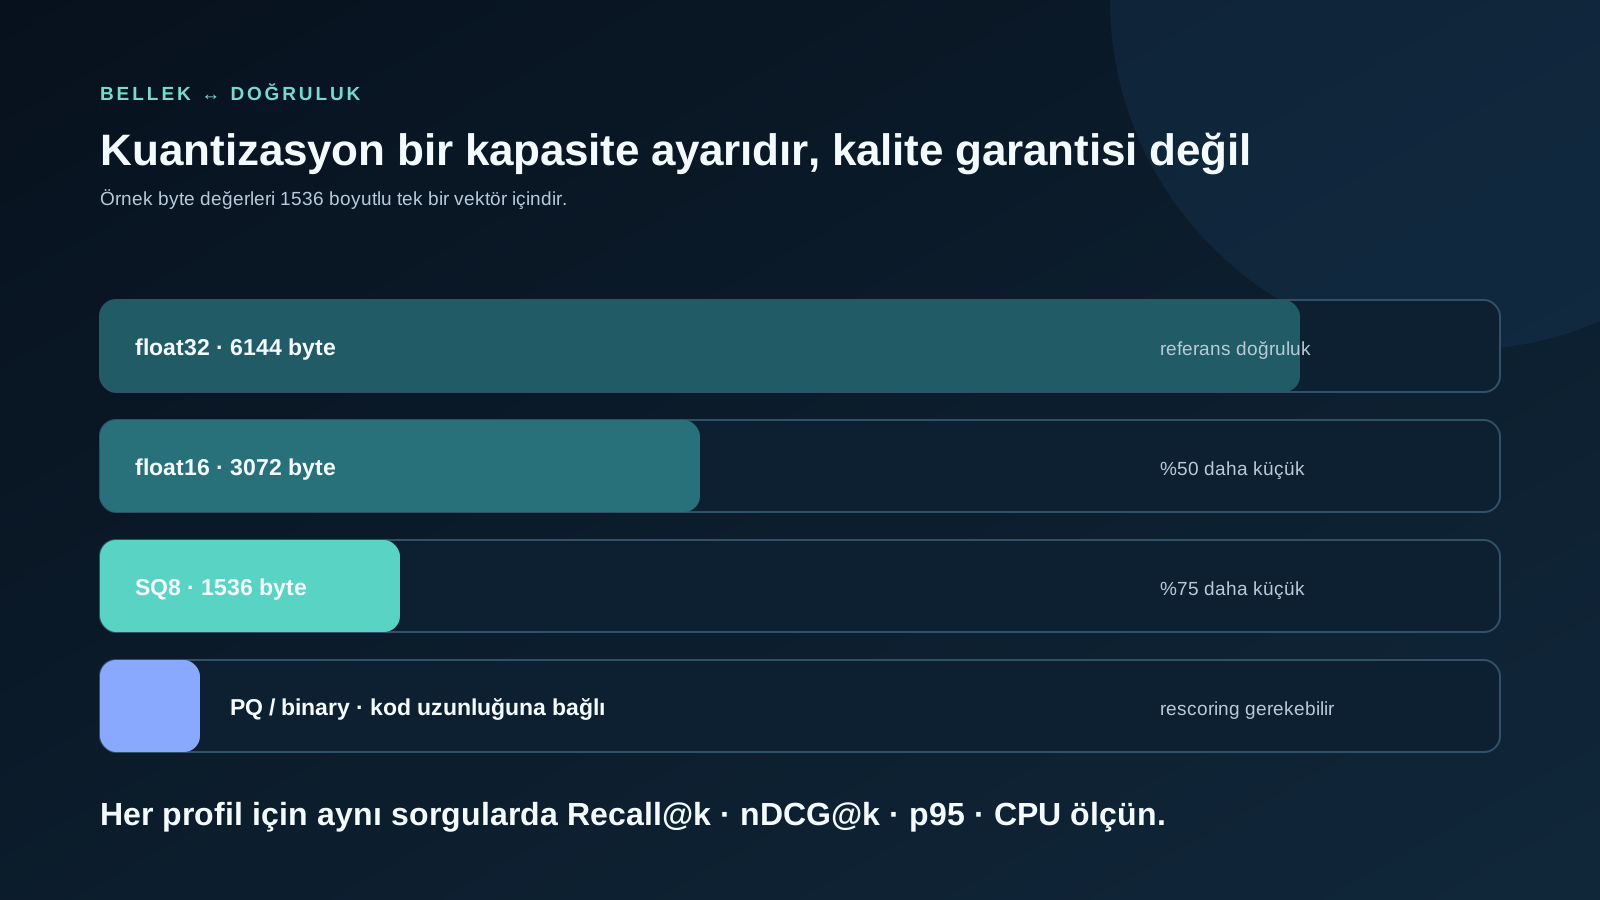
Scalar Quantization, her float32 bileşeni 4 byte yerine çoğunlukla 1 byte int8 kodla temsil eder; vektör kopyasının boyutu yaklaşık %75 azalır. Ancak sistem özgün vektörleri doğrulama veya rescoring için ayrıca saklayabilir. O durumda RAM azalırken disk boyutu özgün + kuantize kopya olur. Qdrant'ın kuantizasyon dokümanı özgünleri diskte, kuantize kopyayı RAM'de tutan hibrit düzeni açıklar.
- SQ8 / int8:
Dbyte/vektör. SIMD dostudur; genellikle ilk denenecek sıkıştırmadır. - float16 / halfvec:
2 × Dbyte/vektör. Yaklaşık %50 küçülür; pgvector 2000 boyut üstündehalfvecile 4000 boyuta kadar indeksleme seçeneği sunar. - Binary quantization:
D/8byte/vektör. Çok güçlü sıkıştırma sağlar; candidate üretip özgün vektörlerle yeniden sıralama yapılması sık görülür. - Product Quantization:
ceil(subquantizer_count × bits / 8)byte/vektör artı codebook. Çok daha küçük kodlar üretir; eğitim, ayar ve kalite doğrulaması gerekir.
Recall yalnız %1–2 düşer ifadesi evrensel değildir. Embedding dağılımı, distance metric, quantile, kod uzunluğu, ef_search/nprobe, filtre seçiciliği ve rescoring sayısı sonucu değiştirir. Kaliteyi Recall@k, nDCG@k veya iş etiketli retrieval başarısıyla ölçün. Faiss indeks tablosu, HNSW Flat için yaklaşık 4D + bağlantılar, SQ8 için D, PQ için ise seçilen kod uzunluğu kadar byte/vektör modelini açık biçimde gösterir.
6. pgvector belleği: shared_buffers tek RAM havuzu değildir
pgvector, PostgreSQL'in sayfa ve indeks mekanizması içinde çalışır. HNSW indeksinin her byte'ı shared_buffers içine sabitlenmek zorunda değildir; PostgreSQL buffer cache ile işletim sistemi page cache birlikte rol oynar. PostgreSQL kaynak ayarları, dedicated sunucuda shared_buffers için %25'i başlangıç noktası olarak verir ve PostgreSQL'in OS cache'e de dayandığını belirtir. effective_cache_size ise ayrılmış RAM değil, planner tahminidir.
Bununla birlikte sıcak HNSW sayfaları mevcut cache bütçesinden büyükse random page fault ve depolama okuması artar. 5 ms'den 400 ms'ye sıçrama mümkündür ama evrensel bir sayı değildir; NVMe, cache hit oranı, ef_search, eşzamanlılık ve filtre sonucu belirler. pgvector'ın resmî belgeleri HNSW'nin IVFFlat'ten daha çok bellek kullandığını, indeks kurulumunun graf maintenance_work_mem içine sığdığında önemli ölçüde hızlandığını ve varsayılan M=16, ef_construction=64 olduğunu belirtir.
pgvector için kritik bir boyut sınırı da vardır: HNSW/IVFFlat üzerinde vector tipi en fazla 2000 boyutu, halfvec ise 4000 boyutu destekler. Bu nedenle varsayılan 3072 boyutlu text-embedding-3-large çıktısı vector(3072) HNSW indeksiyle doğrudan kullanılamaz. OpenAI isteğinde dimensions değerini 2000 veya altına indirmek ya da halfvec(3072) ile yarı hassasiyetli indeks kurmak gerekir; iki seçenekte de retrieval kalitesini aynı evaluation setinde yeniden ölçün.
-- Gerçek tablo ve indeks boyutunu ayrı ölçün
SELECT
  pg_size_pretty(pg_relation_size('document_chunks')) AS heap,
  pg_size_pretty(pg_relation_size('document_chunks_embedding_hnsw')) AS hnsw,
  pg_size_pretty(pg_total_relation_size('document_chunks')) AS total;

-- HNSW arama kalitesi / gecikme deneyi
BEGIN;
SET LOCAL hnsw.ef_search = 100;
EXPLAIN (ANALYZE, BUFFERS)
SELECT id FROM document_chunks
ORDER BY embedding <=> $1
LIMIT 20;
COMMIT;
7. Qdrant ve Milvus: RAM–disk yerleşimi ayrı bir tasarım eksenidir
Özel vektör veritabanlarının avantajı yalnız ANN algoritması değildir; vektör, HNSW, kuantize kopya, payload ve payload indeksini farklı bellek katmanlarına koyabilmeleridir. Qdrant'ın güncel memory tier modeli yapıları pinned, cached veya cold konumlandırır. cached ve cold mmap kullanır; aralarındaki temel fark başlangıçta cache'i ısıtıp ısıtmamalarıdır. HNSW'yi diske almak random I/O nedeniyle dikkat ister; kuantize kopyayı RAM'de tutup özgün vektörü yalnız top aday rescoring sırasında okumak daha dengeli olabilir.
Milvus da resmî yapılandırmasındaki mmap seçenekleriyle vector field ve vector index için bellek eşlemeyi ayrı açabilir. Bu özellikler 10 kat daha az RAM ile aynı performans garantisi vermez. Veri RAM'i aştıkça page fault, disk kuyruğu ve tail latency büyüyebilir. Doğru iddia şudur: özel motorlar resident set ile disk kapasitesini daha ayrıntılı ayırma esnekliği verir; elde edilen oran SSD, sorgu dağılımı ve kalite hedefiyle ölçülür.
| Mimari | Bellek davranışı | Güçlü taraf | Risk / ölçülecek nokta |
|---|---|---|---|
| PostgreSQL + pgvector | Heap ve indeks sayfaları PostgreSQL + OS cache içinde | İlişkisel filtre, transaction, tek operasyon yüzeyi | Cache rekabeti, yüksek boyutta indeks limiti, write ve ANN yükünün çakışması |
| Qdrant | Vektör, HNSW, quantized copy ve payload için ayrı memory tier | Hibrit RAM/NVMe yerleşimi ve ANN operasyon araçları | Cold HNSW random I/O, segment/optimizer geçici alanı |
| Milvus | Query node yükleme ve vector/index mmap seçenekleri | Dağıtık ölçek ve ayrık sorgu katmanı | Operasyon karmaşıklığı, compaction ve node başına yükleme planı |
| Faiss / gömülü indeks | Seçilen indeks çoğunlukla uygulama sürecinin belleğinde | Az servis, özel pipeline, batch arama | Persistence, metadata, replication ve online update'i uygulama üstlenir |
8. HNSW mi IVFFlat mi daha az bellek kullanır?
IVFFlat graf bağlantıları tutmadığı için indeks yapısı genellikle daha küçüktür; vektörleri coarse centroid'lere bağlı listelerde toplar ve sorguda nprobe kadar listeyi tarar. Fakat IVFFlat full vector saklıyorsa ham 4D maliyeti hâlâ vardır. Faiss'in özetinde IVFFlat yaklaşık 4D + 8 byte/vektör; HNSW Flat ise 4D + bağlantı maliyeti olarak verilir. pgvector'da IVFFlat oluşturmak için temsil edici veri ve uygun lists gerekir; veri dağılımı ciddi değişirse recall yeniden ölçülmeli, gerekirse indeks yeniden kurulmalıdır.
HNSW çoğu interaktif aramada daha iyi speed–recall dengesi ve training gerektirmeden online büyüme sağlar; bunun karşılığında graf belleği, daha yavaş build ve daha pahalı insert ödenir. IVFFlat daha düşük indeks overhead'i ve batch odaklı büyük koleksiyonlarda iyi bir seçenek olabilir. Kararı yalnız QPS ile değil, aynı filtre segmentlerinde Recall@10, p50/p95/p99, build süresi, insert throughput ve yeniden indeks maliyetiyle verin.
9. İndeks RAM'e sığmazsa gerçekte ne olur?
İndeks veya sıcak çalışma kümesi RAM'i aştığında sistem hemen çalışmayı bırakmaz. mmap veya page cache kullanan motorlar gereken sayfaları diskten getirir ve eski sayfaları evict eder. Sorun, HNSW traversal'ın komşu düğümlere dağınık erişmesidir: cache miss başına depolama gecikmesi eklenir. Working set RAM'den belirgin büyük ve sorgular geniş dağılımlıysa major page fault, disk queue depth ve p99 gecikme birlikte yükselir. Swap etkinse veritabanı heap'i de takas edilerek durum ağırlaşabilir.
cache hit ratiotek başına yetmez; major page fault, read IOPS, queue depth ve disk latency izleyin.- p50 iyi kalırken p99 bozulabilir; kapasite kararını yalnız ortalama gecikmeyle vermeyin.
- Filtreli sorgularda aday sayısı düşebilir veya ANN sonrası filtreleme recall'ı bozabilir; gerçek tenant/category dağılımını kullanın.
- Soğuk başlangıç, warm cache ve steady-state testlerini ayrı raporlayın.
- Rebuild, compaction, snapshot ve backup sırasında oluşan geçici disk/RAM tepesini test edin.
10. Replication ve shard matematiği
base_vectors = logical_vectors × replication_factor
node_vectors ≈ base_vectors / shard_count × rebalance_headroom

RAM_cluster = resident_bytes_per_vector × base_vectors
RAM_node = RAM_cluster / active_nodes + process_overhead + query_workspace
Disk_cluster = persistent_bytes × replication_factor + WAL + snapshots + temporary_segments
Replication factor iki ise cluster toplamında vektör ve indeks kopyası yaklaşık iki katına çıkar; iki düğüm olması düğüm başına veriyi otomatik yarıya indirmez. Shard sayısı dağılımı belirler, replica dayanıklılığı. Bir node kaybında kalan node'ların sorgu ve yeniden dengeleme yükünü taşıması gerekir. Managed hizmet maliyetinde de yalnız nominal veri boyutunu değil replica, minimum node sayısı, snapshot, network egress ve yeniden indeksleme saatlerini hesaba katın.
11. Belleği aylık maliyete çevirme
monthly_compute = hourly_node_price × 730 × node_count
monthly_storage = provisioned_GB × storage_price_per_GB_month × replicas
monthly_backup = snapshot_GB × retention_copies × backup_price
monthly_total = compute + storage + backup + network + operations

cost_per_1M_queries = monthly_total / monthly_queries × 1,000,000
Kapasiteyi en küçük RAM'li makineye sıkıştırmak her zaman en ucuz değildir. Cold vector düzeni RAM'i düşürürken daha yüksek IOPS sınıfı, daha fazla node veya daha uzun sorgu süresi isteyebilir. PQ RAM ve disk kazandırırken daha fazla CPU ve tuning emeği getirebilir. pgvector ayrı servis maliyetini kaldırabilir fakat transactional iş yüküyle ANN sorgusunun aynı CPU ve cache'i paylaşması daha büyük PostgreSQL makinesi gerektirebilir.
| Maliyet kalemi | Büyüten değişken | Azaltma seçeneği | Yan etkisi |
|---|---|---|---|
| Resident RAM | N, D, replica, HNSW M, filtre indeksleri | D azaltma, SQ8/PQ, cold originals | Recall veya disk okuması |
| NVMe / disk | Özgün + quantized kopya, WAL, snapshot | Retention ve segment politikası | Kurtarma penceresi |
| CPU | ef_search, rescoring, concurrency | Daha küçük candidate set | Recall düşebilir |
| Operasyon | Cluster, compaction, backup, upgrade | pgvector ile konsolidasyon veya managed servis | İzolasyon ya da kontrol azalabilir |
| Embedding yeniden üretimi | Chunk sayısı, model/boyut değişimi | Sürümleme ve kademeli backfill | Geçiş süresi ve çift indeks |
12. Ölçüm olmadan kapasite kararı vermeyin
Formül fiziksel alt sınırı verir; benchmark gerçek working set'i gösterir. Temsil edici en az yüz bin vektörle başlayın, mümkünse hedef boyuta yaklaşın. Üretimdeki boyut, norm, dil, chunk uzunluğu, tenant dağılımı ve metadata filtrelerini koruyun. Exact aramayı küçük bir ground-truth setinde çalıştırıp ANN sonuçlarını onunla karşılaştırın.
1. Aynı corpus ve 500–2,000 gerçek sorgudan ground truth üret.
2. Her adayda aynı k, filtre ve distance metric kullan.
3. M / ef_construction / ef_search veya lists / nprobe grid'i çalıştır.
4. Recall@10, nDCG@10, p50, p95, p99 ve QPS kaydet.
5. Warm ve cold başlangıcı ayrı ölç.
6. RSS, page fault, IOPS, CPU ve index bytes/point kaydet.
7. Insert + query eşzamanlılığını ve rebuild/compaction tepesini çalıştır.
8. En ucuz değil, SLO'yu geçen en düşük toplam maliyetli profili seç.
Kapasite raporunda bytes/vector en güçlü karşılaştırma birimidir. index_size / live_vector_count ile gerçek motor maliyetini bulun; tombstone ve segment sonrası tekrar ölçün. Ardından resident_RSS / live_vector_count, p95, Recall@k ve cost_per_1M_queries değerlerini aynı satırda yayınlayın. Böylece pazarlama çarpanı yerine yeniden üretilebilir bir mühendislik kararı oluşur.
13. Kopyalanabilir Python hesaplayıcı
from dataclasses import dataclass

@dataclass
class VectorSizing:
    n: int
    d: int
    bytes_per_dim: float = 4
    m: int = 16
    replicas: int = 1
    headroom: float = 1.25

    def estimate(self):
        base = self.n * self.replicas
        vectors = base * self.d * self.bytes_per_dim
        hnsw = base * self.m * 2 * 4 * 1.2
        resident = (vectors + hnsw) * self.headroom
        return {
            'vector_GB': vectors / 1e9,
            'hnsw_GB': hnsw / 1e9,
            'resident_GB': resident / 1e9,
            'resident_GiB': resident / 2**30,
        }

print(VectorSizing(n=1_000_000, d=1536).estimate())
# {'vector_GB': 6.144, 'hnsw_GB': 0.1536,
# 'resident_GB': 7.872, 'resident_GiB': 7.331...}14. Üretim için karar özeti
- Önce gerçek
N,D, veri tipi, named vector sayısı ve replication factor değerlerini yazın. - Ham byte hesabını GB ve GiB olarak ayrı raporlayın.
- Graf, payload index, process/query workspace ve %25–30 headroom'u ayrı satırlarda gösterin.
- SQ8 veya PQ kararını tahmini recall yüzdesiyle değil kendi ground-truth sorgularınızla verin.
- pgvector için heap/index boyutu,
EXPLAIN (ANALYZE, BUFFERS)ve cache baskısını birlikte ölçün. - Qdrant/Milvus için vector, graph, quantized copy ve payload placement'ını açıkça belgeleyin.
- Node arızası ve rebalancing sırasında SLO'nun korunup korunmadığını test edin.
- Aylık fiyatı query sayısına bölün;
cost per 1M queriesile recall ve p95'i aynı karar tablosunda tutun.
TankDev'in RAG ve fine-tuning seçim rehberi, retrieval katmanının hangi probleme hizmet ettiğini; API ve sistem entegrasyonu rehberi ise bu arama katmanının güvenilir üretim akışına nasıl bağlanacağını açıklar. Uygulamalı yapay zekâ hizmetimizi inceleyebilir veya corpus boyutunuzu, embedding modelinizi, hedef recall ve gecikmenizi bizimle paylaşabilirsiniz; varsayım tablosundan ölçülebilir kapasite planına birlikte geçebiliriz.
Sıkça sorulan sorular
011 milyon OpenAI vektörü için kaç GB RAM gerekir?
Varsayılan 1536 boyutlu text-embedding-3-small vektörleri float32 olarak 6,144 GB ham alan kaplar. M=16 HNSW grafı ve %25 payla arama çalışma kümesi yaklaşık 7,9 GB olur. Veritabanı süreçleri, metadata, filtre indeksleri ve işletim sistemiyle tek node üretim planı için en az 12 GB, rahat kapasite için 16 GB RAM uygundur. SQ8 RAM'de ve özgünler diskteyse arama katmanı yaklaşık 2,1–2,5 GB'a inebilir.
021 milyon 3072 boyutlu vektör kaç GB yer kaplar?
Float32 ham boyut 12,288 GB veya 11,44 GiB'dir. M=16 HNSW ve %25 çalışma payıyla salt arama çalışma kümesi yaklaşık 15,6 GB olur. Payload, süreçler ve yeniden indeksleme payı nedeniyle 24–32 GB RAM sınıfı daha gerçekçi bir üretim başlangıcıdır.
03Vektör indeksi RAM'e sığmazsa ne olur?
Sistem mmap veya page cache üzerinden disk sayfalarını okumaya devam edebilir; ancak HNSW'nin dağınık erişimi cache miss, major page fault, IOPS ve özellikle p99 gecikmesini artırır. Artışın 10 veya 100 kat olması mümkündür fakat sabit değildir; NVMe, sorgu dağılımı, ef_search, filtre ve eşzamanlılıkla ölçülmelidir.
04HNSW her zaman ham vektörün yüzde 20–50'si kadar ek RAM mi kullanır?
Hayır. Graf maliyeti çoğunlukla N ve M ile, ham vektör maliyeti N ve D ile büyür. Aynı M için 384 boyutta graf oranı daha büyük, 3072 boyutta daha küçüktür. Motorun katman, işaretçi, hizalama ve metadata düzeni de sonucu değiştirir. Yüzde yerine byte/vektör formülü ve ölçülen indeks boyutu kullanılmalıdır.
05Scalar Quantization recall'ı yalnız yüzde 1–2 mi düşürür?
Böyle evrensel bir sınır yoktur. Kayıp embedding dağılımı, metric, quantile, candidate sayısı ve rescoring'e bağlıdır. Bazı corpuslarda fark çok küçük olabilir, bazılarında iş açısından önemli olabilir. Kararı aynı ground-truth sorgularda Recall@k veya nDCG@k ölçerek verin.
06HNSW mi IVFFlat mi daha az bellek kullanır?
IVFFlat graf bağlantısı tutmadığı için indeks overhead'i genellikle daha düşüktür; full vector kullanıyorsa 4D ham vektör maliyeti devam eder. HNSW daha fazla bellek ve build süresi karşılığında çoğu interaktif workload'da daha iyi speed–recall dengesi verir. IVFFlat training ve veri dağılımı değişince yeniden doğrulama gerektirir.
07pgvector HNSW indeksinin tamamı shared_buffers içine sığmalı mı?
Hayır. PostgreSQL hem shared_buffers hem işletim sistemi page cache kullanır; effective_cache_size de ayrılmış bellek değildir. Yine de sık erişilen indeks sayfaları toplam cache bütçesini aştığında disk okumaları ve tail latency artar. Heap ve indeks boyutunu ayrı ölçüp EXPLAIN ANALYZE BUFFERS ile gerçek sorguları test edin.
08Qdrant veya Milvus on-disk moduyla 10 kat daha az RAM garanti eder mi?
Hayır. Bu motorlar vektör, graph ve payload'ı RAM ile disk arasında ayrı yerleştirme esnekliği verir. Kazanç kuantizasyon, cache locality, SSD ve sorgu dağılımına bağlıdır. Daha az RAM; daha çok disk I/O, CPU rescoring veya daha yüksek p99 anlamına gelebilir.
09Embedding boyutunu yarıya indirmek RAM'i de yarıya indirir mi?
Ham vektör ve SQ8 kopya maliyeti yaklaşık yarıya iner; HNSW graf bağlantı maliyeti aynı N ve M için aynı kalır. Toplam sistem belleği bu yüzden tam yüzde 50 düşmeyebilir. Ayrıca kısa embedding için retrieval kalitesi yeniden ölçülmelidir.
10Vektör veritabanı maliyetini hangi metriklerle karşılaştırmalıyım?
Aynı corpus ve sorgu setinde Recall@k veya nDCG@k, p50/p95/p99 gecikme, QPS, bytes/vector, resident RSS, build süresi, insert throughput ve cost per 1M queries birlikte karşılaştırılmalıdır. Replica, snapshot, yeniden indeksleme ve operasyon emeği toplam maliyete eklenmelidir.