
LLM şişkinliğine son: Jev ve System One karar modelleri üretim mimarisine nasıl entegre edilir?
Her iş akışı metin yazmaz. Jev'in Choice, Score ve Noul kararlarını eşik, denetim ve insan onayıyla güvenilir bir üretim katmanına dönüştürme rehberi.
· TankDev Mühendislik
Yapay zekâ otomasyonlarında maliyetin önemli bir bölümü metin üretmekten değil, metin üretmesine gerek olmayan kararları büyük bir dil modeline sordurmaktan doğar. Bir destek kaydının muhasebe, satış veya teknik destek kuyruğuna gideceğini belirlemek; bir aracın çağrılıp çağrılmayacağını seçmek; bir talebin risk eşiğini aşmasını kontrol etmek çoğu zaman paragraf gerektirmez. Yazılımın ihtiyacı, okunacak yanıt değil çalıştırılacak bir değerdir.
Jev, TypeSafe'in System One modeli olarak sunduğu karar odaklı bir yaklaşımdır: uygulama bir durum (state) ve tiplenmiş sorular gönderir; model metin yerine seçim, puan veya olasılık döndürür. Resmî dokümantasyon, Choice ve Score için güven bilgisi, Noul için 0–1 arası olasılık tanımlar. Bu, LLM'leri gereksiz ilan etmez. Doğru tasarım, karar ve ifade işlerini farklı katmanlara koyar.
Sorun: yapılandırılmış çıktı, her zaman yapılandırılmış karar değildir
JSON Schema, function calling ve Pydantic doğrulaması LLM çıktısının biçimini güvenilirleştirebilir. Ancak model yine talimatı yorumlar, token token metin üretir ve uygulama bu üretimin tamamlanmasını bekler. Bir LLM'in route: billing döndürmesi geçerli JSON olabilir; ama bu, yanlış rotanın seçilmediğini, düşük güvenin ele alındığını veya çağrının iş yüküne uygun maliyetle yapıldığını göstermez.
System 1 ve System 2: faydalı bir mimari benzetme
Kahneman'ın System 1 / System 2 ayrımı, burada teknik bir metafor olarak yararlıdır. System 1 katmanı hızlı ve dar kapsamlı bir yargı verir: bu talep hangi kuyrukta, risk var mı, hangi araç seçilmeli? System 2 katmanı ise bağlam kurar, gerekçe üretir, alternatifleri açıklar ve metin yazar. Geleneksel LLM çoğu zaman ikinci sınıfa daha yakındır; Jev gibi karar modelleri ilk sınıftaki dar, ölçülebilir sorulara konumlanır. Bu bir zekâ hiyerarşisi değil, iş bölümü meselesidir.
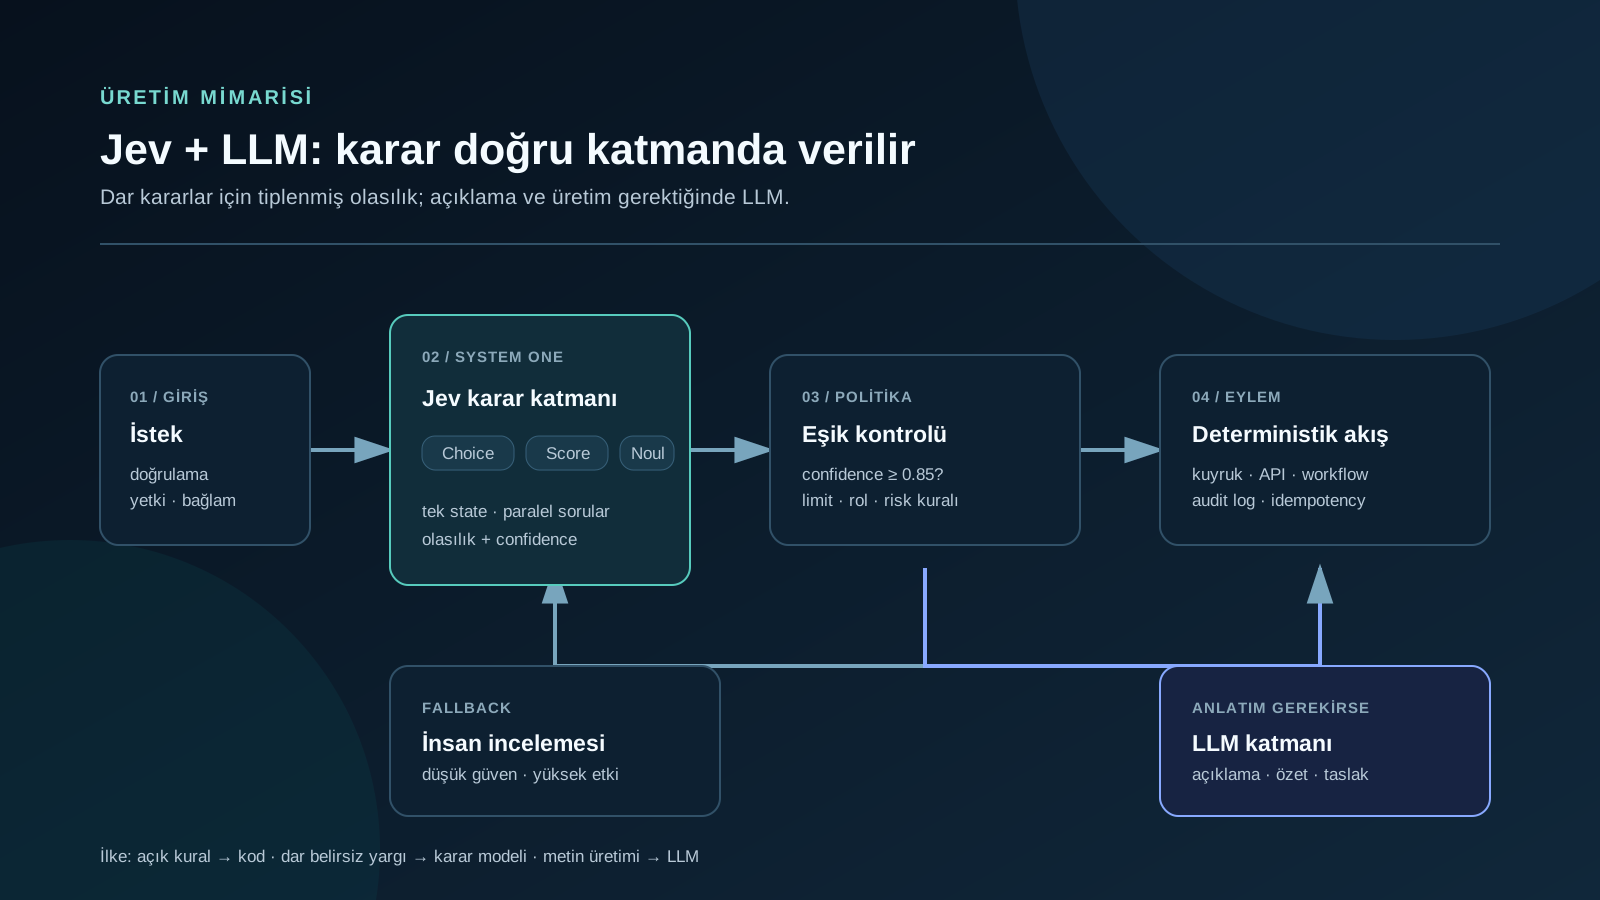
Kullanıcı isteği
      │
      ▼
[Doğrulama + yetki] ── geçersiz ──► reddet / açıklama
      │
      ▼
[Jev: route, risk, human_needed]  ← tek state, paralel sorular
      │
      ├─ confidence ≥ eşik ─► deterministik workflow / tool
      ├─ confidence < eşik ─► insan inceleme kuyruğu
      └─ anlatım gerekiyorsa ─► LLM (taslak, özet, açıklama)
                                      │
                                      ▼
                              audit log + metrikler
Üç karar ilkesi: Choice, Score ve Noul
Jev'in API yüzeyi kararın biçimini baştan sınırlar. Soruyu serbest bırakmak yerine, uygulamanın hangi tür cevabı kullanacağını tarif edersiniz. Aynı state üzerinde birden çok soru paralel çalışabildiği için, birbirinden bağımsız küçük yargılar tek bir karar paketi olarak alınabilir.
| İlke | Sorduğu soru | Üretimde örnek | Kodun kullandığı değer |
|---|---|---|---|
| Choice | Hangi seçenek? | Talep hangi ekibe gitsin? | billing | support | sales + dağılım + confidence |
| Score | Tanımlı rubriğe göre ne düzeyde? | Olayın önceliği nedir? | olasılık-ağırlıklı puan + confidence |
| Noul | Bu ifade doğru mu? | İnsan onayı gerekli mi? | P(true) ∈ [0, 1] |
{
  "state": {
    "subject": "Kartımdan iki kez çekim yapıldı",
    "channel": "web",
    "account_tier": "enterprise"
  },
  "questions": {
    "route": {
      "type": "choice",
      "instructions": "Talebi sorumlu ekibe yönlendir.",
      "criteria": {"billing": "ödeme, fatura veya tahsilat", "support": "ürün sorunu", "sales": "satın alma veya teklif"}
    },
    "urgency": {"type": "score", "instructions": "Operasyonel aciliyeti değerlendir.", "criteria": ["düşük", "normal", "yüksek", "kritik"]},
    "human_needed": {"type": "noul", "instructions": "Finansal zarar veya hesap güvenliği nedeniyle insan incelemesi gerekli mi?"}
  }
}
Bu örnekte route yalnızca etiket değildir: uygulama kuyruk, SLA ve erişim sınırını seçmek için onu kullanır. urgency raporlama veya önceliklendirmeye girer. human_needed ise otomatik yanıtı durduracak bir kapı olabilir. Sorular atomik olmalıdır; ‘bu talebi güvenli, acil ve doğru ekibe yönlendir’ tek sorusu hem belirsiz hem de denetlenmesi zordur.
Maliyet ve gecikme: karşılaştırmayı doğru birimle yapın
Fiyat karşılaştırmasında tek bir evrensel benchmark vermek yanıltıcıdır; model, bağlam uzunluğu, cache, çıktı uzunluğu, bölge ve eşzamanlılık sonucu değiştirir. TypeSafe, Jev için milyar input token başına 42 ABD doları ilan eder; bu yaklaşık 1 milyon input token için 0,042 ABD dolarıdır. Bir LLM kararının maliyeti ise yalnız input fiyatı değil, sistem talimatı, üretilen structured output, olası düzeltme çağrısı ve bekleme maliyetidir. Bu nedenle kendi trafik örneklerinizle p50/p95 gecikme, çağrı başına token, fallback oranı ve yanlış karar maliyetini ölçün.
| Ölçüt | Jev / System One karar katmanı | Structured-output LLM |
|---|---|---|
| Çıktı | Tiplenmiş seçim, puan veya olasılık | Şemaya uyan üretilmiş JSON |
| Çalışma biçimi | Aynı state üzerinde paralel, dar sorular | Otoregresif üretim; çıktı token'ları |
| Maliyet hesabı | Input token + platform maliyeti | Input + output + gerekirse yeniden deneme |
| Gecikme | Kısa kararlar için ölçülmeli | Model, çıktı uzunluğu ve yükle değişir |
| Doğru kullanım | Routing, gating, sınıflandırma, risk sinyali | Açıklama, özet, öneri, içerik üretimi |
TankDev karar benchmark'ı: ölçüm sözleşmesi
Bir mimarinin hızlı veya ucuz olduğu, yalnız sağlayıcı demosuyla kanıtlanmaz. Karar kalitesi; veri alanına, seçeneklerin tanımına ve yanlış kararın maliyetine bağlıdır. Bu nedenle TankDev'in önerdiği benchmark, aynı kapalı değerlendirme setini üç yolun önüne koyar: deterministik kural, Jev/System One ve structured-output LLM. Amaç ‘en yüksek yüzdeyi’ bulmak değil, hangi kararın hangi katmanda güvenle otomatikleşebileceğini göstermektir.
Etiketli değerlendirme seti (örn. 500 anonimleştirilmiş talep)
                  │
                  ├──► Deterministik kural ───────► sonuç + süre + maliyet
                  ├──► Jev / System One ──────────► sonuç + dağılım + confidence
                  └──► Structured-output LLM ─────► sonuç + çıktı token'ları

Her sonuç: doğru etiket • p50/p95 süre • çağrı maliyeti • fallback • insan override
Ayrı rapor: kanal • dil • müşteri tipi • yeni/az görülen kategori| Ölçüm | Nasıl hesaplanır | Neden önemlidir |
|---|---|---|
| Seçici doğruluk | Otomatik çalıştırılan kararlar içindeki doğru oran | Yüksek confidence altında otomasyonun gerçek kalitesini gösterir |
| Kapsama | Toplam kayıtların kaçında sistem otomatik eylem aldı | Sadece kolay örneklerde iyi görünmeyi engeller |
| Risk-ağırlıklı hata | Her yanlış sonucu iş etkisiyle ağırlıklandırma | Yanlış yönlendirme ile para/erişim hatasını ayırır |
| p50 / p95 gecikme | İstemciden kararın alınmasına kadar süre | Ortalamanın gizlediği kuyruk ve uç değerleri ortaya çıkarır |
| Fallback ve override | İnsan inceleme ya da sonradan düzeltme oranı | Eşik ve soru tasarımının olgunluğunu gösterir |
Bu yazı sayısal benchmark sonucu iddia etmiyor; burada örnek bir sonuç şablonu vardır. Gerçek sonuç yayınlanmadan önce veri kaynağı, örnek sayısı, etiketleme yöntemi, model/soru sürümü, tarih aralığı ve exclusion kriterleri açıkça kaydedilmelidir. Aksi hâlde karşılaştırma bir mühendislik kanıtı değil, pazarlama grafiği olur.
| Yöntem | Seçici doğruluk | Kapsama | p95 | Çağrı maliyeti | Not |
|---|---|---|---|---|---|
| Kural motoru | ölçülecek | ölçülecek | ölçülecek | ölçülecek | Sadece açık kurallı örneklerde referans |
| Jev / System One | ölçülecek | ölçülecek | ölçülecek | ölçülecek | Confidence eşiği ve kalibrasyonla birlikte |
| Structured-output LLM | ölçülecek | ölçülecek | ölçülecek | ölçülecek | Şema doğruluğu ile karar doğruluğunu ayırarak |
Hibrit üretim mimarisi: karar modeli, politika ve LLM
Karar modelini doğrudan dış sisteme bağlamak yerine araya bir politika katmanı koyun. Policy engine eşik, kullanıcı rolü, işlem limiti, çalışma saati, deneme sayısı ve risk sınıfı gibi deterministik kuralları uygular. Böylece model ‘satıcı ödemesi yüksek riskli’ diyebilir; fakat paranın gönderilip gönderilmeyeceğini uygulamanın açık kuralı belirler.
const decision = await jev.decide(ticket);

const autoRoute = decision.route.confidence >= 0.85;
const needsReview = decision.human_needed.noul >= 0.20;

if (!autoRoute || needsReview) {
  await reviewQueue.enqueue({ ticketId, decision, policyVersion: "2026-09-27" });
  return { status: "pending_review" };
}

await workflow.dispatch({ queue: decision.route.choice, ticketId });
// LLM yalnızca kullanıcıya açıklama veya yanıt taslağı gerekiyorsa çağrılır.
Güven skoru bir yetki değildir: kalibrasyon ve eşik tasarımı
0,85 güven, ‘%85 doğruyuz’ anlamına ancak model sizin veri alanınızda kalibre edilmişse yaklaşır. İlk üretim sürümünde kararları gölgede (shadow mode) kaydedin: model önerisini üretin, gerçek insan veya mevcut kural sonucuyla karşılaştırın, segment bazında hata oranını inceleyin. Dil, müşteri tipi, kanal, ürün ailesi ve yeni kategori gibi dilimler ayrı ölçülmelidir.
- Her karar için state özeti veya güvenli referansı, model sürümü, soru/policy sürümü, sonuç, dağılım, eşik ve nihai eylemi audit log'a yazın.
- Eşiği başarı oranına göre değil yanlış pozitif ve yanlış negatif maliyetine göre seçin.
- Düşük güveni otomatik ‘ret’ saymayın; inceleme, alternatif akış veya daha zengin bağlam seçeneği tasarlayın.
- Model veya soru metni değiştiğinde eski ve yeni sürümü kontrollü olarak karşılaştırın.
Jev'in yapmadığı işler
Jev metin yazmaz; bu nedenle gerekçe, kullanıcıya açıklama, uzun özet, kod veya çok adımlı araştırma için doğru araç değildir. Sabit çıktı alanı, şema dışı cevap üretimini engeller; ancak modelin tanımlı seçeneklerden yanlışını yüksek olasılıkla seçmesini engellemez. ‘Sıfır halüsinasyon’ ifadesini iş kararı doğruluğu olarak okumak hatadır. Ayrıca deterministik iş kuralı açıkça varsa—örneğin tutar > 100.000—model çağrısı yerine normal kod kullanın.
Yayına alma kontrol listesi
- Kararın iş hedefini, izin verilen eylemlerini ve geri alınabilirliğini yazın.
- Her Choice seçeneğini ve Score seviyesini gözlenebilir kriterlerle tarif edin.
- Etiketlenmiş veya insan kararlı bir değerlendirme seti hazırlayın; eğitim verisiyle aynı örnekleri kullanmayın.
- Eşik altında, zaman aşımında ve servis hatasında çalışacak fallback'i belirleyin.
- Kuyruk gecikmesi, model gecikmesi, confidence dağılımı, override oranı, hata oranı ve çağrı maliyetini izleyin.
- Yüksek etkili eylemlerde çift onay, limit, idempotency ve audit log uygulayın.
TankDev, AI otomasyonunu yalnız model çağrısı olarak değil; API, veri, yetki, iş kuralı, kuyruk ve gözlemleme birlikte çalışan bir sistem olarak ele alır. LLM, API ve iş akışlarıyla AI otomasyonu yazımız mimarinin diğer katmanlarını; TAARM güvenilirlik modeli ise çok adımlı akışlardaki hata etkisini açıklar. Otomasyonunuzun karar noktalarını paylaşın; hangi katmanın kod, karar modeli veya LLM olması gerektiğini birlikte tasarlayalım.
Sıkça sorulan sorular
01Jev bir LLM midir?
Hayır. Jev, TypeSafe'in metin üretmeyen System One karar modeli olarak tanımladığı üründür. State ve tiplenmiş sorular alır; Choice, Score veya Noul sonucu döndürür. Bu nedenle sohbet, uzun açıklama veya içerik üretimi için LLM'in yerine geçmez.
02Structured Outputs varken Jev'e neden ihtiyaç duyulur?
Structured Outputs biçimi sabitler; LLM'in üretim maliyetini, gecikmesini veya karar belirsizliğini tek başına çözmez. Jev, kodun doğrudan kullanacağı dar kararlar için tiplenmiş olasılık ve güven sinyali verir. Hangi yaklaşımın uygun olduğu gerçek hata maliyeti ve ölçülen performansa bağlıdır.
03Jev halüsinasyon görmez mi?
Tanımlı şemanın dışına yeni bir sınıf yazamaz. Buna rağmen mevcut seçeneklerden yanlış olanı seçebilir. Bu yüzden confidence, değerlendirme seti, eşik, fallback ve yüksek etkili işlemlerde insan onayı gerekir.
04Neden kararın gerekçesini yazmıyor?
Jev'in hedefi makinenin kullanacağı hızlı karar üretmektir, açıklama üretmek değildir. Kullanıcıya gerekçe gerekiyorsa karar kaydını ve ilgili iş verisini LLM'e veya insan incelemesine vererek ayrı bir açıklama akışı kurun.
05Ajan mimarisinde Jev nereye yerleştirilir?
Tool seçimi, risk kapısı, yönlendirme, spam/uygunluk filtresi ve insan inceleme tetikleyicisi gibi ön karar noktalarına yerleştirilir. Jev sonucu tek başına yetki olmamalı; politika katmanı, izinler, limitler ve audit log ile birlikte uygulanmalıdır.
06Güven eşiği 0,85 olmalı mı?
Evrensel bir sayı yoktur. Eşiği, kendi etiketli örneklerinizdeki kalibrasyon ve yanlış karar maliyetiyle belirleyin. Düşük etkili bir yönlendirme daha düşük eşiği kaldırabilir; para hareketi veya erişim değişikliği insan onayı gerektirebilir.