
AI Otomasyon Güvenilirliği: Çok Adımlı Bir LLM Sistemi Gerçekte Ne Kadar Güvenilir?
Çok adımlı LLM otomasyonunda uçtan uca güvenilirlik: TAARM v1.0 ile başarı sözleşmesi, seri çarpım, retry, Monte Carlo ve açık doğrulama paketi.
· TankDev Mühendislik
Bir otomasyonun güvenilirliği, içindeki modelin tek başına doğru cevap verme oranı değildir. Talebin alınmasından doğrulanmış sonucun kaydedilmesine kadar, tanımlanmış işin doğru tamamlanma olasılığıdır. LLM çağrısı, API, veri tabanı ve görsel üretimi aynı akışta birleştiğinde her bağımlılık bu sonucu etkiler.
TankDev AI Automation Reliability Model (TAARM) v1.0, bu ilişkiyi incelemek için yayımladığımız açık bir hesaplama modelidir. Seri, tüm dalları gerekli paralel, koşullu ve sıralı fallback akışlarında başarı olasılığını, beklenen deneme sayısını ve maliyeti hesaplar. Seed ile tekrarlanabilen Monte Carlo simülasyonu aynı varsayımları yürütme düzeyinde sınar. Model bir sektör standardı, sertifika veya sağlayıcı performans puanı değildir. Olasılık kuralları yerleşiktir; TankDev’in katkısı bunların açık yürütme sözleşmesi, araç ve yeniden üretilebilir doğrulama paketiyle bir araya getirilmesidir.
1. Önce başarı sözleşmesini tanımlayın
Örnek iş: müşteri talebini oku, yapılandırılmış veri çıkar, ürün bilgisi al, teklif oluştur, görsel üret ve sonucu kaydet. HTTP 200 veya geçerli JSON bu işin tamamlandığını kanıtlamaz. Ürün kodu yanlışsa, fiyat güncel değilse veya teklif yanlış müşteriye bağlandıysa teknik yanıt başarılı görünürken iş başarısızdır.
- Transport başarısı: İstek zamanında yanıtlandı mı?
- Yapısal geçerlilik: Çıktı beklenen şemayı sağlıyor mu?
- Anlamsal doğruluk: Alanlar kaynak belge ve iş kurallarıyla uyumlu mu?
- Yan etki doğruluğu: Doğru kayıt yalnızca bir kez mi oluşturuldu?
- Tamamlama ölçütü: Gerekli bütün çıktılar ve kontroller mevcut mu?
TAARM’daki p, başarısı böyle tanımlanmış bir denemenin olasılığıdır. Model ayrı bir hatalı-kabul oranı hesaplamaz. Validator yalnızca JSON yapısını kontrol ediyorsa p’yi “iş doğruluğu” diye adlandıramazsınız. İnsan incelemesi, kural kontrolleri ve temsil edici etiketlenmiş örnekler bu ölçümün parçası olmalıdır. v1.0 genel bir son-teslim süresi eşiği de uygulamaz; simülasyondaki süre yüzdelikleri, zamanında ve doğru tamamlama SLA’sı değildir.
Başarıyı sayılabilir bir iş sonucuna bağlayın
Bu yazı boyunca bir B2B teklif otomasyonunu düşünelim. Başarı sözleşmesi şudur: doğru müşteriye ait talep okunmuş, ürün ve fiyat güncel kaynaktan doğrulanmış, zorunlu teklif çıktıları hazırlanmış ve teklif tek bir kayıt olarak saklanmış olmalıdır. Üretimde ayrıca “beş dakika içinde tamamlanma” koşulu koyabiliriz; hesaplayıcının başarı metriği bu zaman koşulunu içermez. Doğru tamamlama oranı ile zamanında doğru tamamlama oranını ayrı izlemek gerekir.
Örneğin 1.000 başlangıçtan 970'i “completed” durumuna ulaşsın. Sonradan yapılan denetim bunların 20'sinde yanlış para birimi buluyorsa, doğrulanmış iş başarısı 970/1.000 değil, 950/1.000 = %95'tir. Validator tarafından kabul edilme oranı %97'dir. Bu farkı gizleyen bir gösterge paneli, otomasyonu güvenilir gösterirken müşteriye yanlış teklif gönderebilir. Sonuç doğruluğunu ölçmek için başarısız kayıtların yanında kabul edilmiş kayıtların da örneklenmesi gerekir.
2. Basit örnek: yüzde 98,5 neden yeterli olmayabilir?
Varsayılan örnek 8 LLM çağrısı, 3 API çağrısı, 2 veri tabanı işlemi ve 1 görsel üretiminden oluşur: toplam 14 seri adım. Her adımın bağımsız ve tek denemede yüzde 98,5 başarılı olduğunu varsayalım. Kalıcı hata ve ortak başlangıç engeli sıfır olsun. Uçtan uca başarı 0,985 üzeri 14, yani yaklaşık yüzde 80,93 olur. 10.000 akış başlangıcında beklenen başarısızlık yaklaşık 1.907’dir. Bunlar temsili hesaplamalardır, canlı sağlayıcı ölçümü değildir.
R_serial = product(R_i)
R_example = 0.985^14 ≈ 0.8093
Expected failures = N × (1 − R_workflow)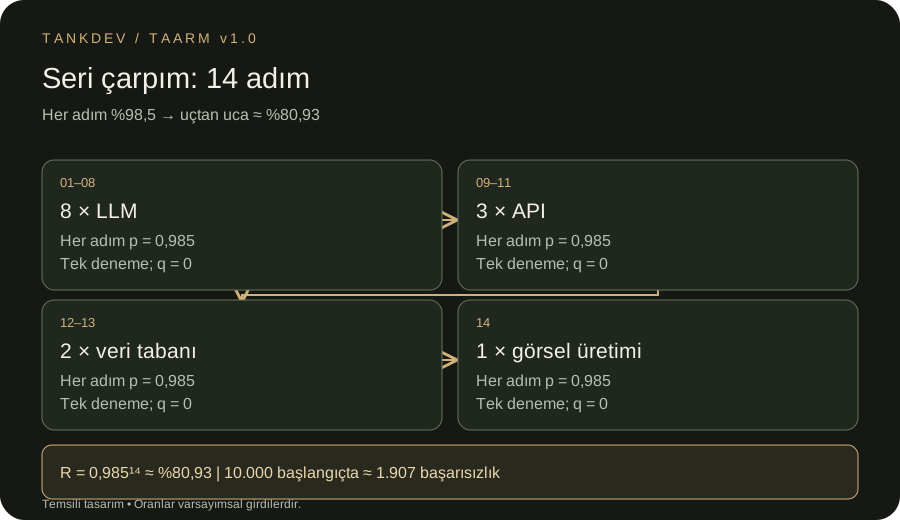
Bu çarpım yalnızca uygun bağımsızlık koşullarında kullanılabilir. Aynı belgedeki eksik bilgi tüm LLM adımlarını etkiliyorsa veya bir API sonucu sonraki kararları yanıltıyorsa bağımsızlık bozulur. NIST seri model açıklaması da bağımsızlık ve ilk bileşen hatasında sistem başarısızlığı varsayımlarını açıkça belirtir; burada aynı olasılık mantığını sonlu iş akışı olaylarına uyguluyoruz.
Aynı varsayım, üç farklı mühendislik kararı
14 adımlı örnekte her adıma aynı oranı vermek, matematiği görünür kılan bir başlangıçtır. Gerçekte bir PostgreSQL işlemi ile görsel üretiminin doğruluk, hata ve maliyet profilleri aynı değildir. Bu varsayılan değerler sağlayıcı önerisi veya sektör ortalaması olarak kullanılmamalıdır.
Tek denemeden iki toplam denemeye geçmek, q=0 varsayımı altında beklenen başarısızlığı 10.000 başlangıçta yaklaşık 1.907'den 31'e indirir. Buna karşılık her adımda %1 kalıcı hata varsa aynı politika yaklaşık 1.340 başarısızlık bırakır. Son olarak başlangıç engeli g=%2 ise q=0 olan iki denemeli tasarım bile yaklaşık %97,69'da kalır. “Retry ekledik” tek başına bir güvenilirlik açıklaması değildir; hangi hata sınıfının tekrar denendiği sonucu belirler.
Hedef %99,5 ise 10.000 başlangıç için hata bütçesi 50'dir. Bağımsız iki denemeli senaryo bu bütçenin altında görünür; kalıcı hatalı ve başlangıç engelli senaryolar üzerinde kalır. Bu karşılaştırma bir tasarım elemesidir. Üretim taahhüdü vermeden önce varsayımların gerçek ölçümlerle doğrulanması gerekir.
3. Düğüm modeli: geçici ve kalıcı hatayı ayırın
Her işlem düğümünde p, kalıcı-hata durumuna düşülmediğinde bir denemenin doğrulanmış başarı olasılığıdır. q, düğüm bu akışta çalıştırıldığında bütün denemelerini başarısız kılan kalıcı-hata durumunun olasılığıdır. a, ilk deneme dahil azami deneme sayısıdır. “İki retry” üç toplam deneme demektir; arayüz toplam denemeyi ister.
| Sembol | Anlam | Sınır |
|---|---|---|
| p | Kalıcı durum yokken deneme başarısı | 0 ≤ p ≤ 1 |
| q | Ulaşılan düğümün bu çalışmada kalıcı hataya girmesi | 0 ≤ q ≤ 1 |
| a | İlk deneme dahil toplam deneme bütçesi | 1–10 |
| g | Herhangi bir düğümden önce ortak başlangıç engeli | 0 ≤ g ≤ 1 |
| b | Koşullu grupta ilk dalın seçilme olasılığı | 0 ≤ b ≤ 1 |
| C | Başarısız başlangıçlar dahil beklenen maliyet | C ≥ 0 |
Kalıcı durum yoksa denemeler sabit p ile bağımsızdır. Kalıcı durum varsa v1.0 seçilmiş deneme bütçesini tüketir; erken kalıcı-hata tespiti modellenmez. Retry maliyetini bu nedenle q oranı da büyütür. İlk denemenin toplam başarı olasılığı (1−q)p’dir; ölçtüğünüz genel başarı oranını doğrudan p’ye yazıp ayrıca q eklemek aynı hatayı iki kez sayabilir.
R_step = (1 − q) × [1 − (1 − p)^a]
E[attempts | reached] = q × a + (1 − q) × sum(k=0..a−1, (1 − p)^k)
E[cost | reached] = cost_per_attempt × E[attempts | reached]
p=0,985, q=0 ve a=2 için düğüm başarısı yüzde 99,9775 olur; 14 seri adımın başarısı yaklaşık yüzde 99,6855’e yükselir. Fakat q her düğümde yüzde 1 olduğunda aynı tekrar politikası uçtan uca yaklaşık yüzde 86,60 üretir. Daha çok retry, kaynak belgede bulunmayan bilgiyi veya eksik erişim yetkisini kendiliğinden oluşturmaz.
Üretimde hangi hatanın yeniden denenebilir olduğunu sınıflandırın. Yazma işlemlerinde idempotency ve sonuç doğrulaması olmadan retry, çift kayıt yaratabilir. Zaman aşımı, uzak tarafta işlemin gerçekleşmediğini kanıtlamaz. AWS’nin timeout, retry ve backoff rehberi bu operasyonel riskleri ele alır. TAARM trafik yoğunluğunun p’yi düşürmesini veya retry storm etkisini hesaplamaz.
p ve q için kısa bir kontrol
p=0,90, q=0,05 ve a=2 olsun. İlk denemedeki genel başarı %85,5; iki denemeli düğüm başarısı %94,05 olur. Beklenen deneme sayısı 0,05×2 + 0,95×(1+0,10) = 1,145'tir. a sonsuza yaklaşırken p>0 için başarı tavanı 1−q, yani %95'tir. Aynı belgeyi tekrar göndermek eksik müşteri numarasını kendiliğinden oluşturmaz.
Buradaki “kalıcı”, bu çalışmanın aynı stratejiyle yapılan denemeleri boyunca kalıcı demektir. Sonsuza kadar çözülemez anlamına gelmez. Eksik bilgiyi müşteriden almak veya farklı bir belge ayrıştırıcıya geçmek yeni bir işlem yoludur. Bunu sabit p ile yapılan bağımsız retry olarak saymak yerine fallback ya da insan müdahalesi olarak tasarlayın.
4. Seri, paralel, koşullu ve fallback aynı şey değildir
Seri grupta çocuklar sırayla çalışır, ilk başarısızlıkta akış durur. R başarı, C maliyet olmak üzere, sonraki çocuğun beklenen maliyeti o çocuğa ulaşılma olasılığıyla ağırlıklandırılır. Bu nedenle 14 adımlı akışta “her başlangıç mutlaka 14 çağrı üretir” varsayımı yanlıştır.
R_serial = product(R_i)
E[C_serial] = sum(i, C_i × product(j<i, R_j))
R_parallel_all = product(R_i)
E[C_parallel_all] = sum(C_i)
R_conditional = b × R_A + (1 − b) × R_B
E[C_conditional] = b × C_A + (1 − b) × C_B
R_fallback = 1 − product(1 − R_i)
E[C_fallback] = sum(i, C_i × product(j<i, 1 − R_j))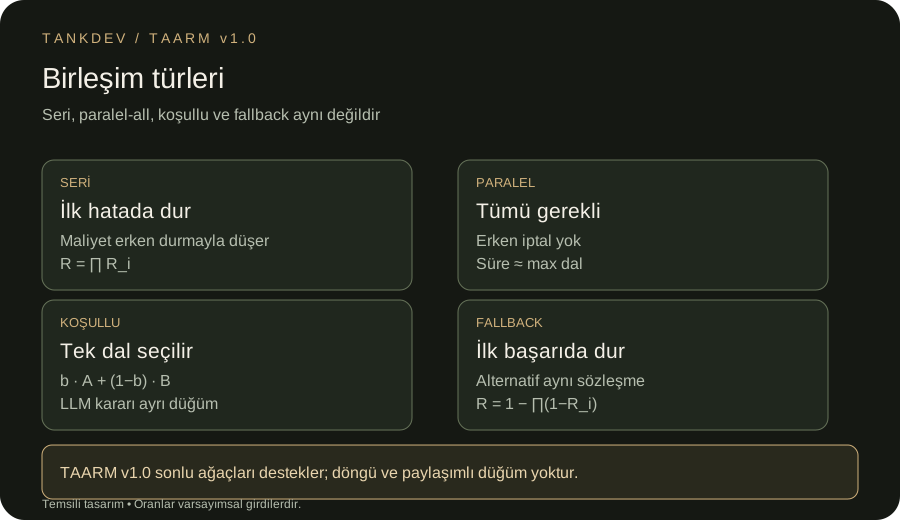
Paralel-all grubunda bütün dallar başlar ve hepsinin başarılı olması gerekir. Erken iptal yoktur. Başarı formülü seriyle aynı olsa da maliyet ve süre farklıdır. Bu, güvenilirlik literatüründeki “en az biri çalışsa yeterli” yedeklilik modeliyle karıştırılmamalıdır.
Koşullu grupta b olasılığıyla A, kalan olasılıkla B seçilir; ikisi birden çalışmaz. Seçim, v1.0’da dal sonuçlarından bağımsız ve maliyetsizdir. Kararı LLM veriyorsa bu karar çağrısını gruptan önce ayrı düğüm olarak ekleyin. Trafiğin yüzde 30’u zor belgelerse bu dalın p değerleri o belge grubuna göre ölçülmelidir.
Fallback, alternatifleri sırayla dener ve ilk doğrulanmış başarıda durur. İkinci sağlayıcının aynı bozuk girdide başarısız olması bağımsızlık varsayımını zayıflatır. Ayrıca alternatif çıktı aynı başarı sözleşmesini sağlamalıdır: zorunlu görsel yerine metin vermek, sözleşme bunu kabul etmiyorsa başarı sayılamaz. Bütün bu gruplar birbirinin içine yerleştirilebilir; v1.0 döngü, paylaşılan düğüm veya keyfi DAG yerine sonlu ağaçları destekler.
İki işlemle maliyet farkını elle hesaplayın
A işlemi tek denemede %90 başarılı ve 1 maliyet birimi; B işlemi %80 başarılı ve 2 birim olsun. q=g=0 kabul edilsin. Seri çalışmada başarı %72, beklenen deneme 1,9 ve maliyet 1 + 0,9×2 = 2,8 birimdir. B yalnızca A başarılıysa çalışır. Paralel-all çalışmada başarı yine %72'dir; her iki işlem başladığı için deneme sayısı 2 ve maliyet 3 birim olur.
A ve B aynı işi karşılayan alternatiflerse fallback başarısı 1−0,1×0,2 = %98, maliyeti 1 + 0,1×2 = 1,2 birimdir. Ancak müşteri doğrulama ve ödeme alma birbirinin alternatifi değildir; sırf daha yüksek oran elde etmek için bunları fallback yapmak iş sözleşmesini bozar. Koşullu yönlendirmede ise trafiğin %30'u A'ya, %70'i B'ye giderse başarı %83 ve maliyet 1,7 birim olur. Dört hesap farklı işler tarif eder; yüzdeler tek başına bir mimari sıralaması değildir.
5. Ortak hata: retry ile aşılamayan bir tavan
Arayüzdeki g, bütün akışı daha hiçbir düğüm çalışmadan durduran ortak başlangıç engelidir. Örneğin gerekli erişim kontrolü başta başarısız olabilir. Bu olayda model sıfır deneme, sıfır işlem maliyeti ve sıfır süre kaydeder; ek başarısızlık kaybı yine uygulanır. Çalışma sırasında başlayan sağlayıcı kesintisiyle aynı model değildir.
R_workflow = (1 − g) × R_tree
E[C_workflow] = (1 − g) × E[C_tree]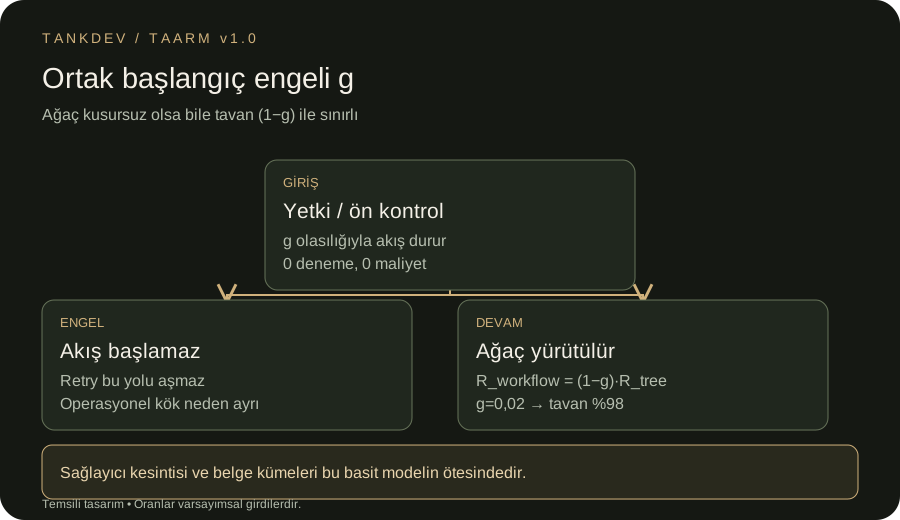
g yüzde 2 ise ağaç kusursuz olsa bile başarı yüzde 98’i aşamaz. Bu basit ortak-hata modeli, bağımlılığı görünür kılar; paylaşılan sağlayıcı arızalarının, kötü belge kümelerinin veya zamana bağlı kesintilerin tamamını temsil etmez. İlgili düğümler arasındaki diğer bağımlılıklar v1.0 kapsamı dışındadır. Gerçek sistemde bu etkiler önemliyse hesaplayıcının tek sonucunu kapasite veya SLA taahhüdüne dönüştürmeyin.
6. Maliyet, çağrı ve süreyi doğru okuyun
Beklenen deneme sayısı, başarısız olanlar dahil başlatılan bütün akışlar üzerinden hesaplanır. “Dış çağrı” LLM, API ve görsel denemelerini kapsar; veri tabanı işlemlerini dışarıda bırakır. Düğüm başına ücret sabittir ve başarısız denemeler de aynı ücreti taşır. Gerçek token uzunluğu, cache indirimi, araç ücretleri ve sağlayıcı faturalandırma koşulları ayrıca değerlendirilmelidir.
Ek hata maliyeti, başarısız akış başına girdiğiniz kayıp ile beklenen başarısızlık sayısının çarpımıdır. İşlem harcaması bu tutara dahil değildir. Örneğin insan düzeltme emeğini burada tanımlayabilirsiniz; aynı emeği düğüm maliyetine de ekleyerek iki kez saymayın. Model gelir, kâr veya yatırım getirisi tahmini üretmez.
Simülasyonda her deneme sabit süre alır; tekrarlar arasında sabit bekleme vardır. Seri ve fallback süreleri toplanır, paralel-all süresi en uzun daldır. Koşullu grubun süresi seçilen daldır. p50 ve p95, başarılı ve başarısız bütün başlangıçları içerir. Kuyruk beklemesi, rate limit, jitter, değişken token süresi, insan onay kuyruğu ve kapasite paylaşımı dahil değildir. Bu varsayımlar değişmeden bulunan süreler üretim gecikme benchmark’ı sayılamaz.
Teklif akışını adım adım bütçelendirin
Daha somut bir tasarım için dört zorunlu seri işlem seçelim: LLM ile talebi çıkarma (p=0,97; q=0,01; a=2; deneme başına 0,02 birim), fiyat API'sini okuma (0,995; 0,001; 2; 0,001), teklif belgesini üretme (0,98; 0,005; 2; 0,01) ve veri tabanına kaydetme (0,999; 0; 1; 0,001). g=0 olsun. Bunlar ölçülmüş TankDev müşteri verisi değil, hesabı tekrarlayabilmeniz için açıkça seçilmiş girdilerdir.
| İşlem | p | q | a | Maliyet / deneme |
|---|---|---|---|---|
| Talep çıkarma (LLM) | 0.97 | 0.01 | 2 | 0.02 |
| Fiyat okuma (API) | 0.995 | 0.001 | 2 | 0.001 |
| Belge üretme (API) | 0.98 | 0.005 | 2 | 0.01 |
| Kayıt (database) | 0.999 | 0 | 1 | 0.001 |
Bu dört düğümün başarıları sırasıyla %98,9109, %99,8975, %99,4602 ve %99,9'dur. Çarpımları yaklaşık %98,18 eder. Beklenen çalıştırma maliyeti yaklaşık 0,0329 birim/başlangıçtır. 10.000 başlangıçta yaklaşık 182 başarısızlık ve 329 birim çalıştırma maliyeti beklenir. Başarısız iş başına ayrıca 10 birim düzeltme kaybı tanımlanırsa bu kayıp yaklaşık 1.822 birimdir. Bütün tutarlar aynı temsili para birimindedir; bir fiyat teklifi değildir.
İlk LLM düğümündeki toplam denemeyi 2'den 3'e çıkarmak uçtan uca başarıyı yalnızca yaklaşık 0,086 yüzde puan artırır. Aynı düğümde eksik kaynak bilgisini gidererek q'yu %1'den %0,2'ye indirmek yaklaşık 0,793 yüzde puan kazandırır. Bu örnekte veri girişini iyileştirmek, bir retry daha eklemekten daha büyük olasılık kazancı sağlar. Uygulama maliyetleri farklı olabileceği için bu sonuç tek başına yatırım kararı değildir.
Hesaplayıcıda küçük örneği açıp dört seri düğüm oluşturabilir, bu p/q değerlerini yüzde olarak girebilir ve toplam denemeyi ayarlayabilirsiniz. Dört düğümlü senaryonun tam JSON'u ve karşılaştırma hesapları aşağıdaki yeniden üretim paketindedir. JSON indirme düğmesi kendi tasarımınızın girdilerini saklar; model sürümünü ve ölçüm tarihini de karar kaydınızda tutun.
7. Monte Carlo neyi doğrular, neyi doğrulamaz?
Araç 100.000 sanal akış çalıştırır. Her akış için başlangıç engeli, ziyaret edilen düğümlerin kalıcı-hata durumu, koşullu dal seçimi ve bağımsız deneme sonuçları örneklenir. Seed aynı kaldığında aynı ağaç ve sürüm aynı sonucu üretir. Simülasyon arka plandaki browser worker’da yürür; gerçek sağlayıcılara istek göndermez.
Başarı oranının yanında yüzde 95 Wilson aralığı gösterilir. Bu aralık, sabit girdiler altında Monte Carlo örnekleme belirsizliğini anlatır. p ve q’nun yanlış tahmin edilmesini, yanlış validator’ı veya gerçek bağımlılıkları kapsamaz. 100.000 sanal çalışma yapmak 100.000 gerçek iş gözlemlemek değildir. NIST Wilson aralığı açıklaması kullanılan oran aralığının temelidir.
Analitik ve simülasyon sonuçlarının yakınlaşması uygulama tutarlılığı için bir kontroldür; modelin dünyayı doğru temsil ettiğini kanıtlamaz. Beklenen çağrı ve maliyet analitik olarak hesaplanır. Paralel sürelerde en büyük değerin beklenen değeri, beklenen değerlerin en büyüğüyle aynı olmadığından süre yüzdeliklerini örneklenen yürütmelerden çıkarıyoruz.
8. Açık doğrulama paketi ve gerçek benchmark sınırı
v1.0 paketinde seri, paralel-all, koşullu, fallback, kalıcı hata, ortak başlangıç engeli ve iç içe akışları kapsayan sekiz sentetik senaryo vardır. Her biri sabit seed ile 100.000 kez yürütülür: toplam 800.000 sanal çalışma. Sıfır ve bir olasılık sınırları, tekrar sayıları, erken durma maliyeti ve deterministik süre örnekleri ayrıca test edilir. Bu testler gerçekten çalıştırılmıştır; LLM sağlayıcıları üzerinde deney yapılmamıştır.
| Senaryo | Analitik başarı | Simülasyon | Fark (pp) |
|---|---|---|---|
| 14 bağımsız adım | %80,9296 | %80,7110 | -0,2186 |
| Seri grup | %49,6000 | %49,2980 | -0,3020 |
| Paralel · tümü | %49,6000 | %49,5860 | -0,0140 |
| Fallback | %99,6000 | %99,6120 | +0,0120 |
| Koşullu dal | %64,7600 | %65,0460 | +0,2860 |
| Kalıcı hata q | %89,2800 | %89,2500 | -0,0300 |
| Başlangıç engeli g | %89,6400 | %89,6060 | -0,0340 |
| İç içe akış | %57,1183 | %57,0410 | -0,0773 |
Ham doğrulama çıktısı: validation.json. Kaynak kodu ve test komutları aşağıdaki yeniden üretim paketindedir.
Bu sayfadaki doğrulama tablosu ve indirilebilir JSON, çalıştırılmış testin çıktısını gösterir. Model kaynak kodu, test betiği, girdiler ve seed değerleri yayımlanır. Simülasyon-gerçeklik ayrımı, yanlış bir kesinlik hissinden daha değerlidir. “TankDev benchmark’ında model X yüzde Y başarılı” iddiası üretmek için burada bulunmayan bir canlı değerlendirme gerekir.
Sonuçları bilgisayarınızda yeniden üretin
TAARM v1.0 yeniden üretim paketini indirin. Paket model.ts, model.test.mjs, tarayıcı worker'ı, sekiz senaryonun ham çıktısı, bu yazıdaki dört adımlı teklif örneği ve SHA-256 dosya manifestini içerir. Harici npm paketi ya da sağlayıcı anahtarı gerektirmez. ZIP'i açtıktan sonra Node.js 24.19.0 ile paket klasöründe aşağıdaki komutları çalıştırın. Bu, testte kullandığımız çalışma ortamıdır.
node model.test.mjs
node editorial.test.mjs
İlk komut sekiz sentetik senaryoyu yeniden çalıştırıp public/research/taarm-v1/validation.json dosyasını üretir. İkinci komut yazıdaki sayısal örnekleri sınar ve tarayıcı worker'ının aynı seed ve girdiler için model kaynağıyla aynı simülasyon sonucunu verdiğini denetler. Seed dizisi ilk senaryoda 20260921'den başlar ve her senaryoda bir artar. Aynı kod, çalışma ortamı ve girdilerle aynı sonuçları karşılaştırabilirsiniz.
Tablodaki “fark”, simülasyon eksi analitik sonuçtur ve yüzde puan cinsindendir. Sekiz senaryonun her birinin %95 aralığında çıkması bir test zorunluluğu değildir; çoklu karşılaştırmalarda dışarıda kalan sonuçlar olabilir. Test ayrıca analitik eşitlikleri ve sınır durumlarını kontrol eder. Kaynakla simülasyonun uyuşması uygulamayı sınar; canlı sağlayıcı performansını kanıtlamaz. Metnin bu revizyonu model denklemlerini değiştirmez: model sürümü 1.0.0, editoryal paket revizyonu 2'dir.
9. Gerçek otomasyonunuzdan p ve q nasıl elde edilir?
Önce başarı sözleşmesini dondurun; sonra temsil edici örnekleri belge türü, dil, uzunluk, müşteri akışı ve hata sınıfına göre ayırın. Kullandığınız model/sürüm, prompt, validator, araç şeması ve tekrar politikasını kaydedin. Eğitim veya prompt ayarlaması için kullanılan örneklerle son değerlendirme kümesini karıştırmayın. p ve q’yu yalnızca toplam başarı oranından ayrı ayrı tanımlayamazsınız; deneme geçmişi ve hata sınıfı gerekir.
- Akış kaydı: run_id, senaryo sürümü, başlangıç zamanı, giriş grubunun anonim kimliği, iş sonucu ve insan doğrulaması.
- Düğüm kaydı: node_id, attempt_index, provider/model_version, validation_version, hata sınıfı, gecikme, token/işlem maliyeti ve idempotency anahtarı.
- Tekrar kaydı: Aynı girdiyle tekrar mı, değişmiş prompt ile yeni strateji mi? İkincisi aynı p’li bağımsız retry varsayımına uymayabilir.
- Veri ayrımı: Sürekli hatalı girdiler ve geçici hatalar ayrı incelenir; başarısız denemeler veri kümesinden çıkarılmaz.
- Raporlama: Payda, gözlem aralığı, örnek sayısı, belirsizlik ve başarısızlık örnekleri başarı yüzdesinin yanında yayımlanır.
Örneğin doğrulanmış 200 gerçek koşuda hiç hata görmemek yüzde 100 garanti değildir. Üstelik sonraki ay belge dağılımı veya model sürümü değişirse önceki ölçüm taşınamayabilir. Güvenilirlik izleme; başarı oranı kadar validator’ın kaçırdığı hataları ve değişen girdi dağılımını da izlemelidir. Paylaşılan veriden kişisel bilgiler ve sağlayıcı anahtarları çıkarılmalıdır.
Gerçek benchmark için yayımlanması gereken kayıt
Canlı bir değerlendirmede “başarı %99” demeden önce örneklem seçimi, veri dilimleri, başarı rubriği ve insan değerlendirme prosedürü dondurulmalıdır. Aynı girdileri karşılaştırılan mimarilere uygulayın; istem, model, validator ve retry değişikliklerini sürümleyin. Aşağıdaki kayıt, doldurulacak bir ölçüm şablonudur; yapılmış deney sonucu değildir.
experiment_id / observation_window / workflow_version
dataset_version / inclusion_rules / held_out_examples
success_contract / adjudication_method / completion_deadline
provider_and_model_versions / prompt_hash / validator_version
starts / verified_correct / accepted_but_incorrect / unresolved
attempts_by_error_class / cost_all_starts / latency_distribution
confidence_interval_method / excluded_cases_and_reasons
Üretim kayıtlarında yalnızca ulaşılmış düğümlerin gözlenmesi seçim etkisi yaratır. Seri akışın son adımına gelen talepler, başta elenen taleplerden daha kolay olabilir. p'yi son adıma ulaşan popülasyon üzerinden yorumlayın; bağımlılıklar varsa tek bir genel çarpım yerine giriş türüne göre ayrı senaryolar kurun. Değişen prompt ile yeniden deneme de aynı p'li tekrardan farklı bir müdahaledir.
Örneğin 200 denetlenen işte sıfır hata görmek kesin %100 güvenilirlik sağlamaz: bu örneklem için iki taraflı %95 Wilson aralığının alt sınırı yaklaşık %98,12'dir. Büyük bir Monte Carlo örneklemi, küçük gerçek örneklemin bu belirsizliğini gidermez. Hesaplayıcıda iyimser, temel ve kötümser p/q senaryolarını ayrı çalıştırmak kararın girdilere ne kadar duyarlı olduğunu gösterir.
10. Sonuçtan mimari kararına geçmek
Hesaplayıcıdaki “tek-düğüm iyileştirme potansiyeli”, bir düğümün p=1 ve q=0 olması durumundaki uçtan uca artıştır. En düşük p her zaman en büyük fırsat değildir: nadiren ziyaret edilen bir fallback veya koşullu dalın etkisi düşük olabilir. Bu metrik kök neden tespiti, gerçekleşebilir iyileştirme veya maliyet-fayda sıralaması değildir.
Sonucu kullanarak üç soru sorun: Kaç adım gerçekten zorunlu? Hangi hatalar aynı stratejiyle yeniden denenebilir? Hangi durumda insan incelemesi veya farklı bir iş yolu gerekir? Gereksiz çağrıyı kaldırmak, doğrulamayı yan etkiden önce yapmak ve zorunlu olmayan görseli teklifin ana başarı sözleşmesinden ayırmak, yalnızca retry sayısını artırmaktan farklı tasarım kararlarıdır.
TankDev’in AI otomasyon mimarisi rehberi LLM, validation, API, kuyruk ve insan onayının üretimde nasıl birleştiğini anlatır. TAARM bu mimarinin bir karar destek parçasıdır. Gerçek güvenilirlik; ölçülmüş girdiler, doğru başarı sözleşmesi, güvenli yan etkiler ve işletim disipliniyle kurulur.
Hesaptan üretim kontrolüne
Teklif sistemi için kabul edilmiş bir sonuç, dış sisteme güvenle aktarılana kadar tamamlanmış sayılmamalıdır. Örnek durum akışı aşağıdaki gibi kurulabilir. Hata sınıfları ile deneme sayacı veri tabanında kalıcı olmalıdır; worker yeniden başladığında sınırsız retry döngüsü oluşmamalıdır.
received → extracting → validating → ready_to_commit → completed
retriable_error → retry_scheduled → previous_step
missing_information → needs_review → corrected_input → validating
unknown_write_outcome → reconcile → completed | needs_review
API zaman aşımında hemen yeni bir teklif oluşturmak yerine idempotency anahtarıyla önceki işlemin sonucunu sorgulayın. Teklif kaydı ile dış sisteme gönderim niyetini aynı yerel transaction içinde saklayan transactional outbox, “kayıt var ama mesaj kayboldu” aralığını yönetmeye yardımcı olur. Teslimat yine tekrarlanabilir; alıcı aynı olay kimliğini ikinci kez işlememelidir. Audit log, hangi girdinin hangi sürüm ve insan kararıyla sonuca dönüştüğünü korumalıdır.
İnsan incelemesi de %100 başarılı, sıfır süreli bir düğüm değildir. İnceleyici kapasitesi, bekleme süresi, karar hatası ve çalışma saatleri vardır. TAARM v1.0 kuyruk kapasitesini modellemediği için “needs_review” yolunu otomatik tamamlanmadan ayrı raporlayın. Üretim panelinde en az doğrulanmış otomatik tamamlama, incelemeye yönlendirme, yanlış kabul, tekrar/uzlaştırma, başlangıç başına maliyet ve zamanında doğru tamamlama bulunmalıdır.
Bir sürümü yayımlamadan önce üç durdurma koşulu belirleyin: doğrulanmış başarı hedefin altına inerse ne olacak, düzeltme kuyruğu kapasiteyi aşarsa kim devreye girecek ve başlangıç başına maliyet bütçeyi geçerse hangi otomasyon yolu kısıtlanacak? Bu koşulları örnek hata enjeksiyonlarıyla sınayın. Başarı oranının yanında sistemin başarısızlığı nasıl yönettiği de tasarımın parçasıdır.
TankDev yaklaşımı: ölçülebilir karar, izlenebilir sistem
TAARM, iş sürecinin başarı sözleşmesini sistem tasarımıyla ilişkilendiren bir karar aracıdır. Veri tabanında tutarlılık, API entegrasyonunda güvenli yan etkiler, otomasyonda kontrollü tekrar ve AI çıktısında doğrulama birlikte düşünülmelidir. Daha yüksek bir hesaplayıcı yüzdesi hedeflemek yerine gerçek müşteri işinin doğru, izlenebilir ve ekonomik biçimde tamamlandığını göstermek gerekir.
Akışınız için başarı sözleşmesi ve ölçüm planını netleştirmek isterseniz bizimle iletişime geçin.